
هوش مصنوعی جدید گوگل معرفی شد؛ Gemini 3.8 همزمان با فکر کردن با شما حرف میزند
هوش مصنوعی جدید گوگل معرفی شد؛ Gemini 3.8 همزمان با فکر کردن با شما حرف میزند
گوگل دو مدل هوش مصنوعی جدید از خانواده Gemini 3.8 را معرفی کرده است که تمرکز ویژهای روی گفتوگوی صوتی طبیعی، استدلال چندمرحلهای و اجرای همزمان ابزارها دارند. این مدلها با هدف ساخت دستیارهای صوتی پیشرفتهتر توسعه یافتهاند؛ دستیارهایی که میتوانند ضمن حفظ جریان مکالمه، وظایف پیچیده را نیز در پسزمینه انجام دهند.
مدلهای Gemini 3.8 Live و Gemini 3.8 Live Extended Thinking برای طیف مختلفی از کاربردها طراحی شدهاند. گوگل میگوید هدف از توسعه این نسل، نزدیکتر کردن تعامل انسان و هوش مصنوعی به یک مکالمه واقعی است؛ بهگونهای که کاربر بتواند با زبان طبیعی صحبت کند و بدون توقف یا اجرای دستی مراحل مختلف، انجام یک کار پیچیده را به هوش مصنوعی بسپارد.
دو مدل جدید Gemini 3.8 برای دو نوع نیاز متفاوت
گوگل برای مدلهای تازه خود دو رویکرد متفاوت در نظر گرفته است. Gemini 3.8 Live بیشتر با هدف ارائه عملکرد سریع، مقیاسپذیر و مقرونبهصرفه ساخته شده و در کنار توانایی مکالمه روان، از قابلیت درک ورودیهای بصری نیز بهره میبرد. این مدل برای موقعیتهایی مناسب است که سرعت پاسخگویی و طبیعی بودن تعامل اهمیت زیادی دارد.
در سوی دیگر، Gemini 3.8 Live Extended Thinking برای وظایفی ساخته شده که به پردازش و استدلال بیشتری نیاز دارند. این نسخه میتواند مسائل چندمرحلهای را بررسی کند و پیش از رسیدن به پاسخ نهایی، مراحل بیشتری از پردازش را پشت سر بگذارد. به همین دلیل گوگل آن را گزینهای مناسبتر برای ساخت عاملهای صوتی پیشرفته و انجام گردشکارهای پیچیده میداند.
هر دو مدل در سطح محصول بهعنوان اجزای اصلی برای ساخت عاملهای صوتی آماده استفاده در محیطهای واقعی معرفی شدهاند. چنین عاملهایی تنها وظیفه پاسخ دادن به کاربر را ندارند؛ بلکه باید بتوانند زمینه مکالمه را حفظ کنند، درخواستهای مختلف را دنبال کنند و در صورت نیاز با ابزارها و API های دیگر ارتباط برقرار کنند.
عملکرد Gemini 3.8 Extended Thinking در آزمونهای مختلف
گوگل برای نسخه Extended Thinking مجموعهای از نتایج بنچمارک را نیز منتشر کرده است. بر اساس دادههای ارائهشده از سوی این شرکت، این مدل در شاخص Artificial Analysis Speech to Speech Quality Index امتیاز ۸۲٫۶ را به دست آورده و در جایگاه نخست این ارزیابی قرار گرفته است.
در آزمون τ-Voice که عملکرد مدلها را در انجام وظایف عاملمحور بررسی میکند، Gemini 3.8 Live Extended Thinking به امتیاز ۶۸٫۶ درصد رسیده است. این مدل همچنین در آزمون τ-Voice-banking از مجموعه Sierra امتیاز ۳۵٫۱ درصد را ثبت کرده است؛ آزمونی که توانایی مدل در مدیریت وظایف مرتبط با خدمات بانکی را مورد ارزیابی قرار میدهد.
مدل جدید گوگل در Big Bench Audio نیز امتیاز ۹۷٫۷ درصد کسب کرده است. گوگل در معرفی این نتایج تأکید دارد که مدلهای جدید، ضمن ارائه چنین سطحی از عملکرد، از نظر هزینه نیز برای استفاده در مقیاس بالا طراحی شدهاند و میتوانند در مقایسه با مدلهای پیشرفته رقیب، گزینهای رقابتی باشند.
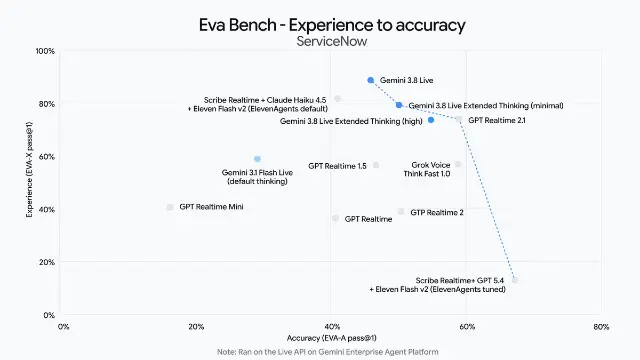
در ارزیابی ServiceNow’s EVA-Bench نیز مدلهای خانواده Live توانستهاند مرز کارایی را در برخی گردشکارهای پیچیده جابهجا کنند. ترکیب دقت، سرعت و کیفیت مکالمه در چنین کاربردهایی اهمیت زیادی دارد؛ زیرا عاملهای سازمانی باید علاوه بر فهم درست درخواست، بتوانند تعامل خود را با کاربر حفظ کرده و مراحل مختلف یک فرایند را دنبال کنند.


گفتوگوی طبیعیتر با درک تصویر و اجرای ابزار در پسزمینه
یکی از قابلیتهای قابل توجه Gemini 3.8 Live توانایی پردازش ورودیهای بصری با سرعت بالا است. این ویژگی به مدل اجازه میدهد اطلاعاتی را که کاربر از طریق تصویر در اختیارش قرار میدهد، وارد روند مکالمه کند و پاسخهایی متناسبتر با شرایط ارائه دهد.
از سوی دیگر، این مدل میتواند در جریان یک مکالمه میان ۹۷ زبان پشتیبانیشده جابهجا شود. بنابراین کاربر در صورت تغییر زبان در میانه گفتوگو، لزوماً مجبور نیست مکالمه را متوقف کرده و تنظیمات زبان را بهصورت دستی تغییر دهد.
قابلیت مهم دیگر، امکان اجرای ابزارها و فراخوانی API ها در پسزمینه است. در چنین شرایطی، هوش مصنوعی میتواند در حالی که مکالمه با کاربر ادامه دارد، عملیات موردنیاز را نیز انجام دهد. این رویکرد میتواند تجربه استفاده از دستیارهای صوتی را از یک سیستم صرفاً پاسخگو به عاملی تبدیل کند که قادر به انجام واقعی وظایف باشد.
Gemini 3.8 Extended Thinking چگونه همزمان فکر و صحبت میکند؟
در نسخه Extended Thinking، گوگل تلاش کرده است فرایند استدلال طولانیتر را بدون از بین بردن حس طبیعی مکالمه اجرا کند. مدل میتواند هنگام پردازش یک درخواست پیچیده، گفتوگو را کاملاً متوقف نکند و در عوض با نشانههای کوتاه و طبیعی به کاربر نشان دهد که درخواست او همچنان در حال بررسی است.
برای مثال، مدل ممکن است در ابتدای فرایند با عباراتی مانند «صبر کن بررسی کنم» واکنش نشان دهد و سپس هنگام انجام مراحل مختلف، وضعیت کار را برای کاربر توضیح دهد. به این ترتیب، انتظار برای انجام یک وظیفه چندمرحلهای کمتر شبیه مواجهه با یک سیستم متوقفشده خواهد بود.
هدف این طراحی آن است که استدلال عمیقتر با ریتم طبیعی مکالمه ترکیب شود. چنین قابلیتی بهخصوص برای دستیارهایی اهمیت دارد که قرار است وظایف چندمرحلهای را انجام دهند؛ زیرا کاربر باید بداند درخواستش در چه مرحلهای قرار دارد، بدون اینکه مجبور باشد برای هر مرحله فرمان جداگانهای صادر کند.
SynthID؛ نشانهگذاری صوتهای تولیدشده با هوش مصنوعی
گوگل همزمان با توسعه قابلیتهای صوتی، روی قابل شناسایی بودن محتوای تولیدشده توسط هوش مصنوعی نیز تمرکز کرده است. طبق اعلام این شرکت، صداهایی که توسط محصولات هوش مصنوعی گوگل تولید میشوند با فناوری SynthID نشانهگذاری خواهند شد.
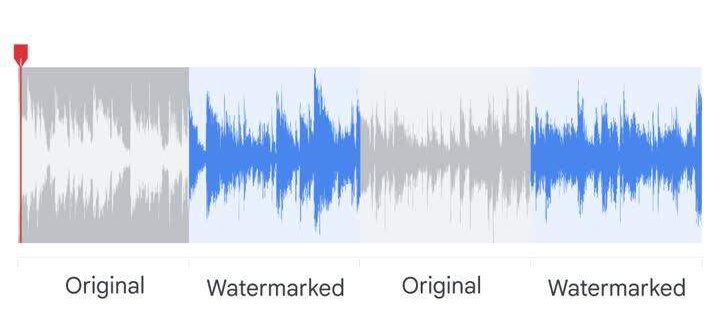
این نشانه بهصورت نامحسوس در خروجی صوتی قرار میگیرد و برای کاربر به شکل یک برچسب قابل مشاهده ظاهر نمیشود. هدف از چنین روشی، فراهم کردن امکان تشخیص محتوای تولیدشده توسط هوش مصنوعی و کمک به مقابله با انتشار محتوای گمراهکننده یا اطلاعات نادرست است.
دسترسی به Gemini 3.8 Live و Extended Thinking
گوگل اعلام کرده است که Gemini3.8 Live از امروز در اختیار کاربران قرار میگیرد و توسعهدهندگان میتوانند از طریق Gemini API و Google AI Studio به آن دسترسی داشته باشند. در بخش سازمانی نیز نسخه خصوصی پیشنمایش این مدل در Gemini Enterprise ارائه شده و قرار است در ادامه به Gemini Enterprise for Customer Experience نیز راه پیدا کند.
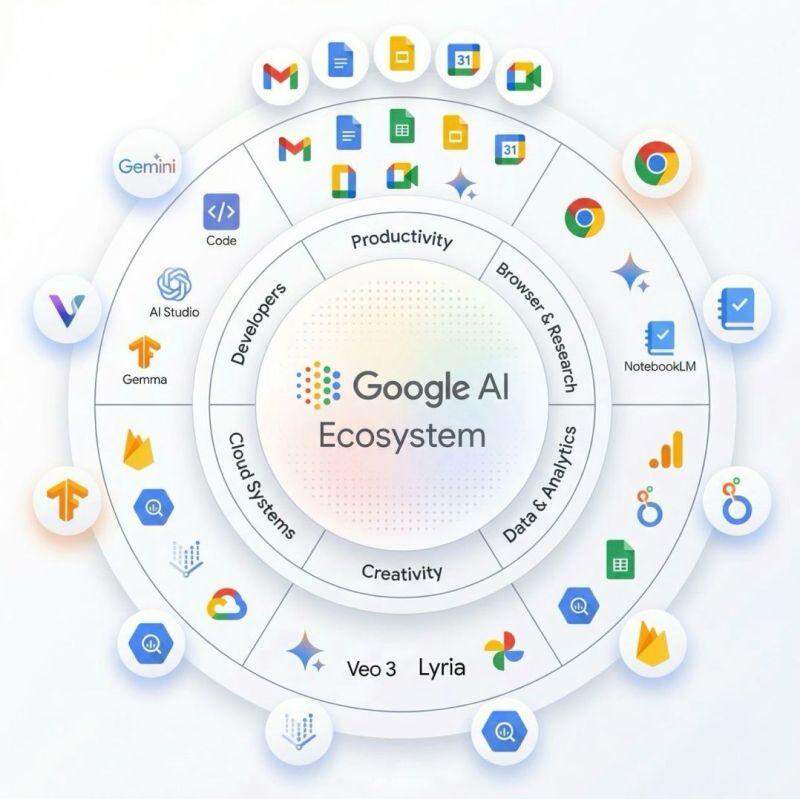
برای کاربران عادی نیز دسترسی به قابلیتهای این مدل از طریق Search Live آغاز شده است. به این ترتیب، قابلیتهای صوتی Gemini تنها محدود به محیط توسعهدهندگان نخواهد بود و بهتدریج در سرویسهای مختلف گوگل گسترش پیدا میکند.
برای کاربران عمومی، این مدل در Gemini Live عرضه میشود و مشترکان Google AI Pro و Ultra نیز میتوانند از قابلیتهای آن در Workspace استفاده کنند.
جمعبندی نهایی
معرفی Gemini 3.8 Live و Gemini 3.8 Live Extended Thinking نشان میدهد گوگل در حال حرکت به سمت نسلی از دستیارهای هوش مصنوعی است که تنها به پرسشهای کاربران پاسخ نمیدهند، بلکه میتوانند مکالمه را دنبال کنند، اطلاعات بصری را درک کنند، درباره مسائل پیچیده استدلال کنند و همزمان ابزارهای موردنیاز را اجرا کنند.
تفاوت اصلی این دو مدل در نوع کاربرد آنهاست؛ نسخه Live بیشتر بر سرعت، مقیاسپذیری و مکالمه روان تمرکز دارد، در حالی که Extended Thinking برای وظایف پیچیدهتر و استدلال چندمرحلهای ساخته شده است. اگر این قابلیتها در محصولات مختلف گوگل به شکل گستردهتری پیادهسازی شوند، نقش تعامل صوتی در استفاده روزمره و سازمانی از هوش مصنوعی میتواند بیش از گذشته پررنگ شود